一、识别框架
1.1 混合结构
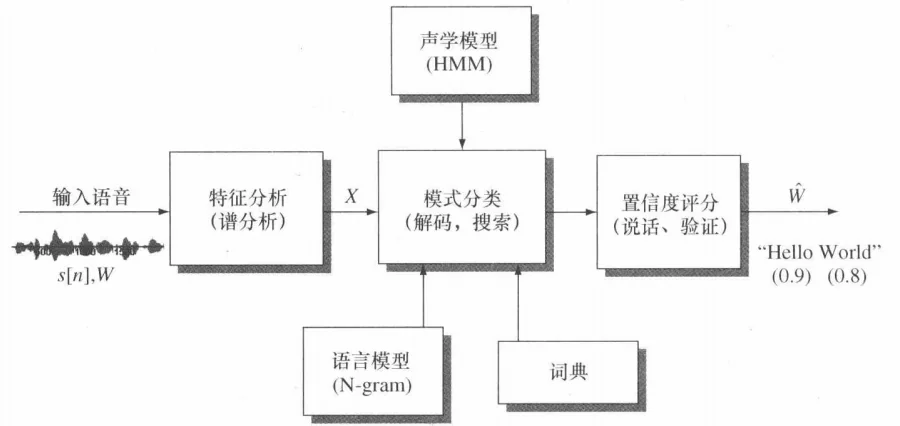
语音识别模型训练包含两个方面,即声学模型训练和语言模型训练。声学模型训练要求在尽可能多的上下文环境中录制每个模型单元(整词或音素)的语音,以便统计学习方法可为每个模型状态建立准确的统计分布。声学模型训练依赖于语音段的准确标记,语音段按照模型单元标注脚本切分得到。声学模型训练的第一步是将语音切分成识别模型的单元,然后切分得到的语音段同步地为每个词汇单元模型建立统计模型分布。针对语言模型训练问题,需要一个大规模的文本训练集,且该训练集可以反映当前任务用语的句法。
其中W为词串,X为特征序列。P(X|W)称为声学模型,P(W)语言模型。 x一般为梅尔频倒谱系数(MFCC)或 线性预测倒谱系数(LPCC)。w为音素时,称为音素模型。使用上下文相关的音素模型如三音子模型。
二、声学模型
音素:最小的语音单位,不能再切分;音节:听觉上最自然、最小的语音片段,由一个或多个音素构成。
2.1 音节知识
人耳感知到的一次发音起伏,一般一个音节有且只有一个元音(元音是音节核心)。 汉语里大多:一个汉字 = 一个音节
汉语普通话的音节是待音调的,数量约为400个(无调音节),读音约1300个(带调音节)。百度百科-太阳-音节
声调对于音节而言基本上是音节全程的。声调犹如一个框箍,将每个音节的音段稳稳地框箍起来,让人觉得这样的音节更“有型”,更稳定。 华东师大-史有为-带调音节:解释汉语的一个出发点
《现代汉语词典》音节统计表共有 1332个带调音节,其中常用的有 1250多个。
唤醒一般不会基于音节建模,不建模跨音节协同发音;连续语音表现差。变调处理很差,单元是固定声调,很难适配连读变调。长尾音节样本少,容易欠拟合;小数据集效果下滑明显。方言/环境泛化能力一般,单元粗,泛化弱。
2.2 音素知识
普通话声母(共21+6个) b、p、m、f、d、t、n、l、g、k、h、j、q、x、zh、ch、sh、r、z、c、s、 注:y→i(零声母替代)、wu→u(零声母替代),不划入基础的声母集合。 新增:_a→a, _o→o, _e→e, _y→yi, _w→wu, _v→yu
普通话韵母(共38个+2特殊)
- 单(6+2个):a、o、e、I(ti/pi/bi)、u、v(ü)、-i1(zi/ci/si,iy,-i前)、-i2(zhi/chi/shi,ix,-i后)、ê(欸,不同于ei) 注:特殊发音-iz(ri),《汉语拼音方案》把er作为单韵母。不清楚书中为什么把e和ê合并了
- 复(14个):ai、ei(杯)、ao、ou、ia、ie(ê→ie)、ua、uo、üe(ê→ve)、iao、iou(iu)、uai、uei(ui)、er 注:特殊发音io(呦)
- 鼻(16个):an、en、in、un、ün、ian、uan、üan、uen、ang、eng、ing、ong、iang、uang、iong
如果是中文,使用生韵母(声调),模型有40*5+27=227个,应用场景最广泛。
英文的音素
- 元音(20个) [iː] [ɪ] [e] [æ] [ɑː] [ʌ] [ɜː] [ə] [ɔː] [ɒ] [uː] [ʊ] [eɪ] [aɪ] [ɔɪ] [əʊ] [aʊ] [ɪə] [eə] [ʊə]
- 辅音(28个) [p] [b] [t] [d] [k] [g] [f] [v] [θ] [ð] [s] [z] [ʃ] [ʒ] [h] [tʃ] [dʒ] [m] [n] [ŋ] [l] [r] [j] [w] [tr] [dr] [ts] [dz]
传统英语音标体系(如IPA)通常包含48个音素(20个元音+28个辅音),但CMU字典基于ARPAbet符号集,简化了音素分类,合并了部分发音变体,最终确定为39个。
协同发音是指一个音受前后相邻音的影响而发生变化。如:
- 无声除阻(stop that)
- 前期协同发音(I can/kæŋ/ do it, la /æ̃/mb)
- 后滞协同发音(map,ten)
- 浊化:st后的/t/,stop(重度强调是p声带振动)
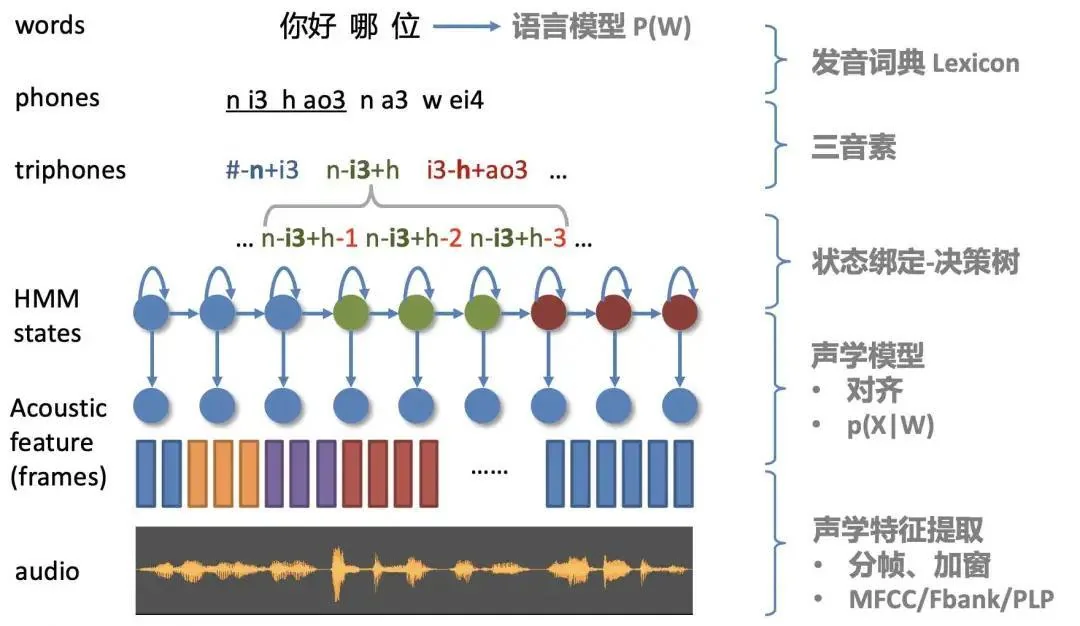
由于存在协同发音问题,因此可以设置三音子或双因子模型,并通过数据驱动聚类和或决策树聚类方法,减少因子数量。
上下文相关(三音子):改变的是"单位是谁"
它不拆分单位,而是让同一个单位根据左右邻居不同而算作不同的建模单元。以"你好" ni3 hao3 为例,先按声韵母切成 n、i3、h、ao3 四个基本单位,再带上左右文:
sil-n+i3 n-i3+h i3-h+ao3 h-ao3+sil
三音子的"三"指的是这个窗口里有三个音(左邻、本身、右邻),中心单位还是一个完整的 n 或 i3,没有被切开。目的是刻画协同发音:同样一个 ao3,前面接 h 和前面接 m 的实际发音不一样,分开建模更准。代价是组合数爆炸,几十个声韵母展开成几万个三音子,所以后面必须用决策树聚类把相似的合并。
2.3 隐式马尔可夫模型 HMM (Hidden Markov Model)
利用所有可能词串中的每个词的相应发音的词典。 N元文法模型用于计算每个可能的词串的语言模型得分。
InfoQ-迈微AI研发社-隐马尔可夫模型原理详解及 Python 实现
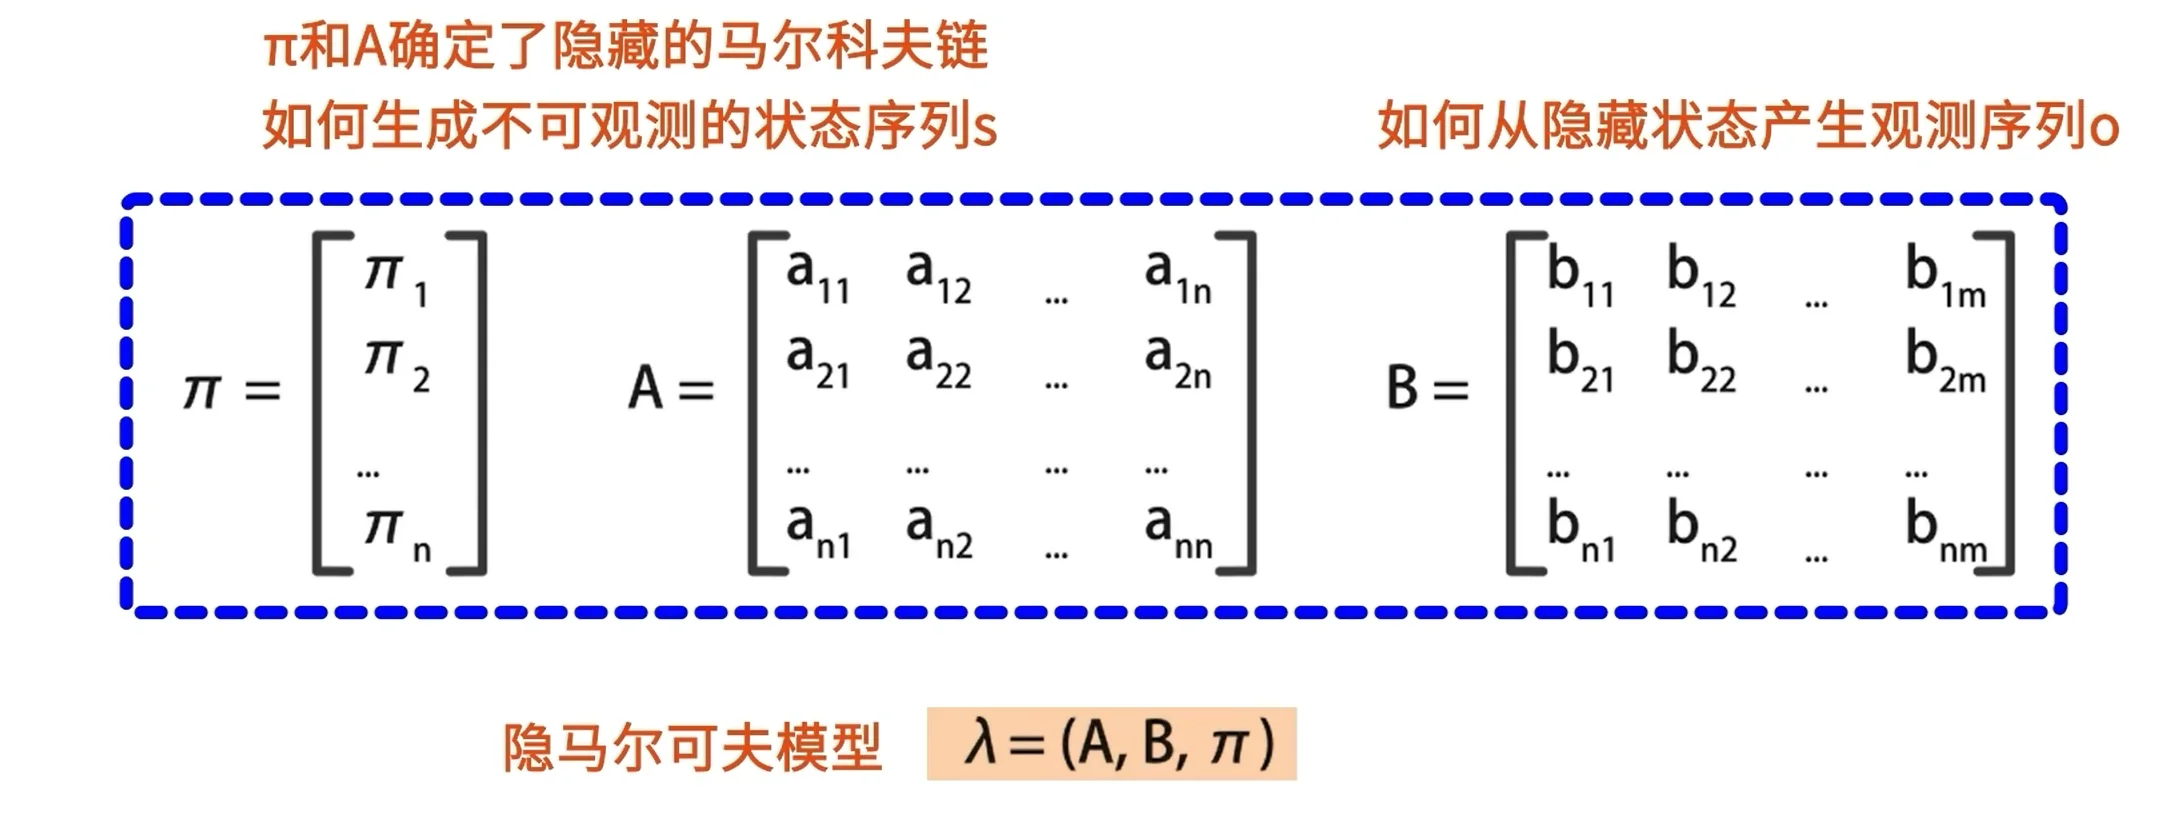
- A阵:隐藏层的状态转移概率矩阵
- π向量:隐藏层的初始概率向量
- B阵:观测层的观测概率矩阵
- O向量:观测序列
- I向量:状态序列
转移概率?
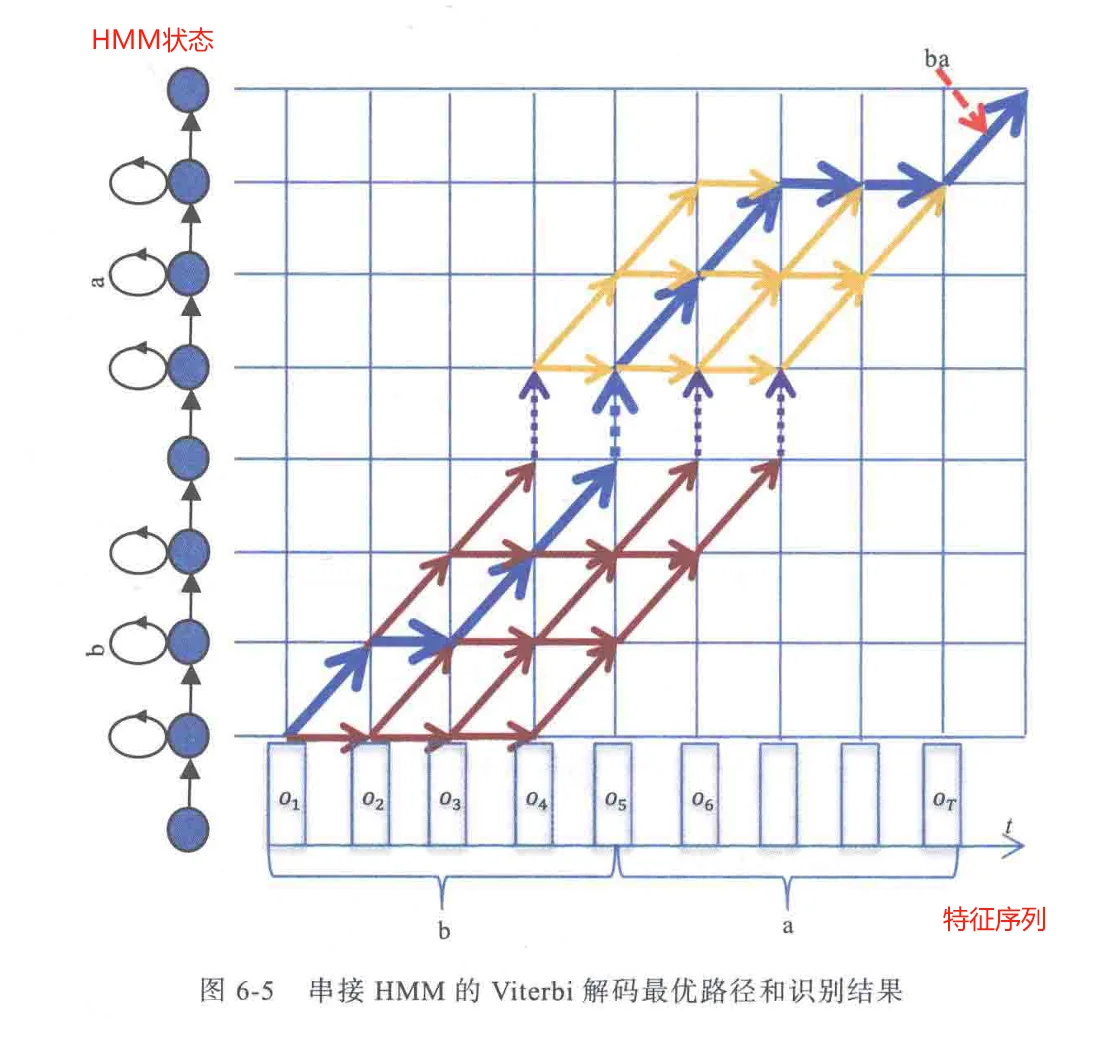
在语音识别中,观测值为语音信号,隐藏状态为文字,根据观测信号推断最有可能的状态序列。可以使用Viterbi算法,逻辑与编程中的动态规划算法类似。但实际上,观测量不是整词,不是音素,是HMM帧。需要在所有链路上进行token的传递,而且要保留竞争路径就要更新的内存。
在声学模型训练中,人工指定参数模型已变得越来越不可行,如何根据训练样本学得最优参数模型。
采用HMM描述音素的发音过程,有3状态形式,中间的状态称为稳定状态(最常用);有5状态形式,中间的三个状态称为发射状态(容易过拟合)。
2.4 DNN-HMM
Hinton, G., et al. Deep Neural Networks for Acoustic Modeling in Speech Recognition(2012) DNN-HMM 奠基论文,核心:用深度神经网络替换 GMM 作为 HMM 状态的发射概率估计,大幅降低词错率,是传统 HMM 语音打字机向深度学习过渡的标志性工作。
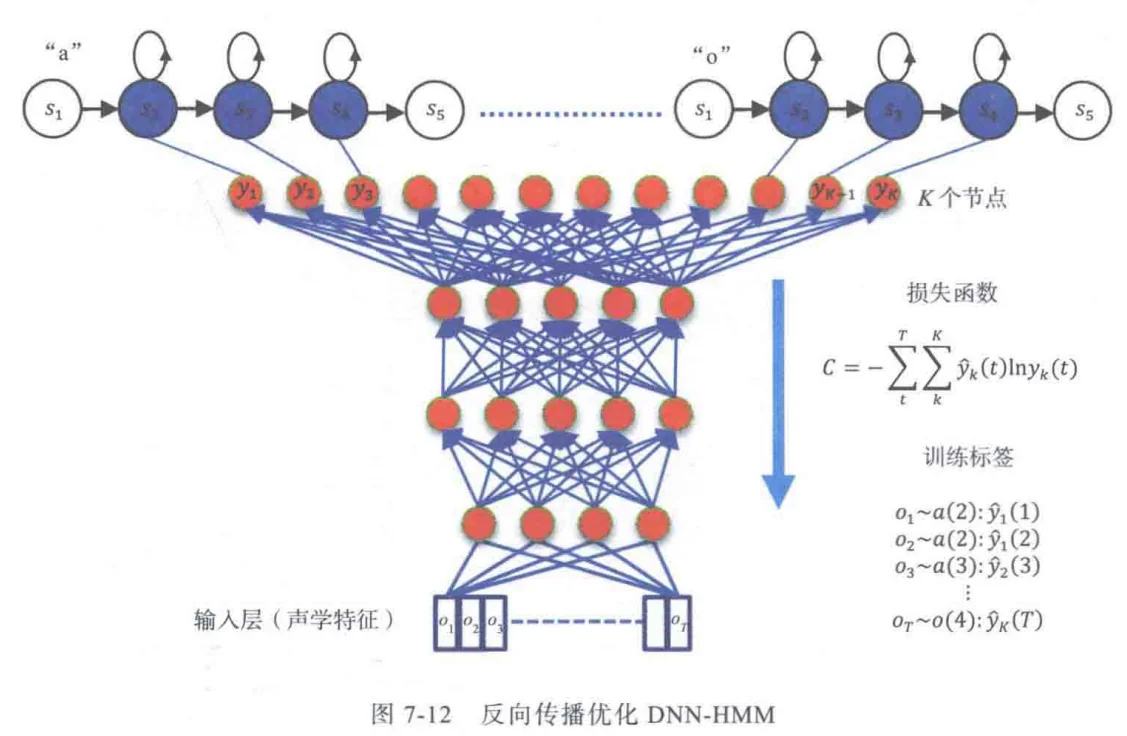
DNN的优势在于能够对包含多帧数据的特征进行处理,表征更丰富的语音上下文变化特征。而且DNN对HMM中后验概率的估计不需要很苛刻的数据分布假设,因此声学特征不一定要采用MFCC或PLP,而是可以采用更原始的特征,如FBank。
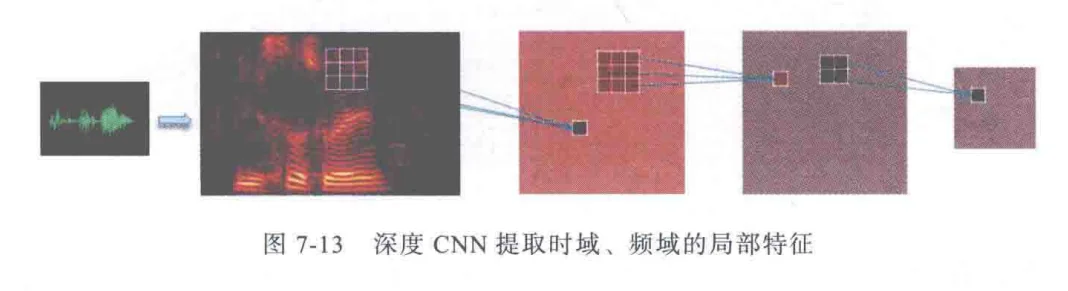
卷积神经网络(CNN)就是把语音模拟为二维“图像”,通过比较小的感受视野来提取时域、频域的局部特征的。
TDNN 可认为是一维CNN(卷积核为3×1).
TDNN-F 是TDNN的因子分解版本,它可以有效减少模型参数数量,并提升识别效果。
2.4.1 输出层
| 步骤 | 数量变化 | 作用 |
|---|---|---|
| 基本单位(声韵母) | 约 60 | 语言学单位 |
| 上下文展开成三音子 | 几万 | 区分不同邻居下的发音 |
| 每个三音子 3 个状态 | 再乘 3 | 区分单位内部的时间段 |
| 决策树聚类绑定 | 压到几千 | 合并声学上相似的状态,变成 senone |
DNN 输出层的每个节点对应一个聚类后的绑定状态。
三、语言模型(Language Model, LM)
传统的语言模型主要采用 n-gram 模型和 modelM,传统模型具有原理简单,推断速度快,容易调整等特点。由于深度学习的发展,基于循环神经网络 (RNN)和 Transformer 的各类预训练语言模型层出不穷。
3.1 n-gram
假设我们手头有一个大规模的文本训练集。对训练集中的每一句话,我们都有一个文本文件,包含了那句话的所有词语。如果假设句中一个词的概率仅依赖其前面的N-1个词,那么就有一个N元文法语言模型的基础。平滑算法使用一元、二元、三元文法(n-gram)频率统计进行;插值:
其中:\(p_3+p_2+p_1=1\),\(\sum_nC(W)=文本训练资料的大小\)
zhihu-baiziyu-似然概率计算 csdn-风华明远-Katz平滑实现
n-gram一般只能对前3~5个词建模,存在局限性。针对任意长句子,可以采用神经网络。
3.1.1 困惑度
困惑度(Perplexity, PPL)是语言模型(Language Model, LM)评估中的核心指标,它既可用于描述一句话的预测难度,也可用于衡量整个语料库(或语音样本对应的文本)的模型性能。其本质是衡量模型对给定序列的不确定性或平均分支因子。数学表达式为:
其中:
- \(S = (w_1, w_2, \dots, w_N)\) 是测试序列(句子或语料库中的词序列)。
- \(P(w_i \mid w_{1:i-1})\) 是模型预测第 \(i\) 个词的条件概率。
- \(N\) 是序列中词的总数(不包括句子起始符
<s>和结束符</s>)。
序列困惑度例子:来源
语料集困惑度:计算时将语料集中所有序列(如句子)合并为一个长序列,统计全局的平均对数概率。\(PPL = exp(-\frac{1}{N_{total}}\sum_{S\in corpus} P(S))\)
命令来源:ngram -ppl dev.txt -order 3 -lm out.lm -debug 2 > out.ppl
通过 -debug 2 定位高困惑度的句子,分析模型弱点(如罕见词、语法错误)。
File dev.txt: 100 sentences, 2000 words, 500 OOVs
    Log Probability: -5000.0
    Perplexity: 120.5 (excluding OOVs) / 150.2 (including OOVs)
    Detailed sentence logs...
模型的困惑度虽然很小,但预测的误差却很大,因此,模型的最终质量还要由实际应用的效果来检验。
判决集外词(Out-Of-Vocabulary)的概率:常见的6W词时,OOV率约为4%。
3.1.2 平滑方法
由于统计语料有限,所以存在数据稀疏的情况;
- 折扣法(discounting):从已有词的观察概率调配一些给未出现词的观察概率。
- 回退法(backoff):基于低阶模型估计未观察到的高阶模型。
- 插值法(interpolation):基于多个模型进行预测,并使用权重进行混合。
| 方法 | 优势 | 局限 | 适用场景 |
|---|---|---|---|
| Good-Turing | 理论严谨,适合未登录词分配 | 计算复杂度高 | 大规模语料库预处理 |
| Kneser-Ney | 结合上下文多样性,效果最优 | 实现复杂,需调参 | 高精度N-gram模型 |
| 线性插值 | 简单高效,缓解稀疏性 | 需手动或自动优化权重 | 实时性要求高的任务 |
| Add-One/Add-K | 实现简单,适合小规模数据 | 过度平滑,高频词概率低估 | 快速原型开发或教学示例 |
当前研究热点包括:
- 神经平滑融合:将Kneser-Ney等传统方法与神经网络结合,提升小样本性能。
- 动态平滑策略:根据输入数据自适应调整平滑参数。
- 多模态平滑:扩展至语音、图像等非文本数据的概率估计。
SRILM命令:ngram-count -text train.txt -order 3 -write out.count
默认使用Good-Turing折扣法和Katz回退法。语料太少,则使用Witten_Bell折扣法-wbdiscount,针对较多语料采用 modified Kneser-Ney平滑法-interpolate -kndiscount。
3.1.2.1 Good-Turing
Good-Turing :zhihu, cornell.edu 只看出现频次,不看词类字数。 核心假设:
- 高频的计数可能包含噪声,其真实出现频率可能略低于观测值。因此可以略微调低高频次的概率(折扣)。相对的而低频计数更接近真实频率。
- 相同词频的词条使用相同的概率符合预期。if two words appear the same number of times in the corpus, we assume that they have the same probability of occurring in general.
缺点:对高频的折扣可能过度。依赖\(N_{r+1}\)的稳定性。无法捕捉局部依赖。高阶n-gram的扩展问题。
若词条A在样本中出现c次,则c称为词频;\(N_c\)为词频为c的词条数;N为样本数,\(N=\sum_{c=1}^{c_{max}} N_c\)。 中间量:
折扣因子
折扣后的概率为(c>=1)
对于样本中未出现的词汇,有:
例子:Good-Turing 应用到2-gram的例子 》 大模型
Good-Turing设置gtmin和gtmax后,为什么需要矫正因子A,折扣率d的定义也变了? 通过引入矫正因子A,可以调整平滑后概率质量的分配比例
折扣率:
最后计算最大似然函数:
- 对于c>gtmax, 直接使用似然结果,并假定随机变量是相互独立的。
- 对于gtmin<=c<=gtmax, 使用Katz平滑方法,并使用折扣率d计算概率。
- 对于d<0,书上说是简化公式,没太理解。
3.1.2.2 Katz
如果p(flying|it is)未出现时,回退到p(flying|is),间接引入上下文。
在Good-Turing的词频受限版本上,进行分段处理:
- c > c' 时, 直接采用最大似然法
- 当0< c < c'时,采用Good-Turing模型
- 其他情形, \(backoff(w_{t-2}w_{t-1}P(w_t|w_{t-1}))\)
核心假设:
- 当单元的出现次数值比较大时,是比较可靠的,是不需要进行折扣的。阈值可以取5或3(小于等于5进行折扣)。
3.1.3 Neural LM
youtube.Language Models zhihu-川陀学者-语言模型与RNN part 1 , part 2 DNN: Improvements: No sparsity problem, Don't need to store all observed. problems: Fixed windows is too small; Enlarging window enlarges W; Window can never be large enough.
RNN: Improvements: Can process any length input; use information from many steps back;Model size doesn't increase for longer input;Same weights applied on every timestep. disadvantages: slow; difficult to access information from many steps back;computing loss and gradients across entire corpus is too expensive.
RNN语言模型的输入输出向量的维度就是词典大小,每个词都被表示成高维、稀疏的向量,会导致RNN神经网络参数众多。为了降低运算复杂度,一个有效的办法是对词进行分类。
3.2 Transformer LM / GPT
TODO
四、WFST识别框架
传统解码器是:使用构建词HMM和特征帧序列,通过Viterbi算法解码,最终通过语言模型约束获取识别结果。Viterbi算法将语音特征序列与HMM的状态直接对齐。缺点是需要各个模块之间的约束;解码速度慢。
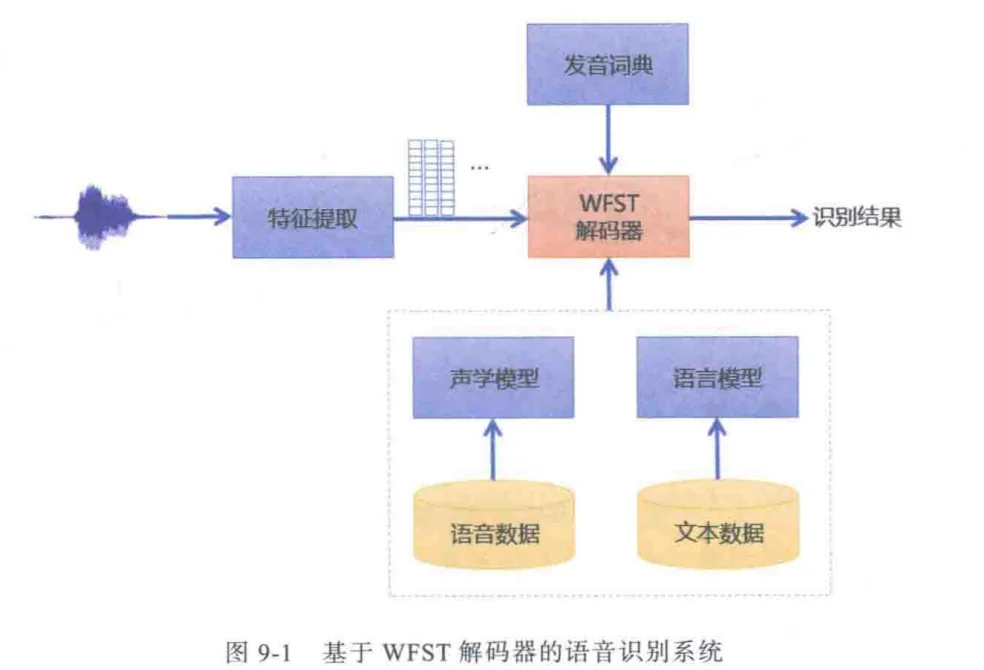
引入WFST的核心目的是高效建模和优化识别流程,将声学模型、语言模型、词典等组件统一整合,提升识别准确率和效率。
WFST(Weighted Finite-State Transducer):加权有限状态转换机,由有限状态接收机(FSA)拓展而来,在ASR领域常被称为“解码器”。
一个WFST定义了一个关系(而不是一个函数),它的输入是一个字母表上的字符串,而输出是另一个字母表上的多个(或者零个)字符串以及对应的概率。
解码器:best path, lattice(哪些帧经历了哪些状态,置信度,更多的竞争路径N-best list)
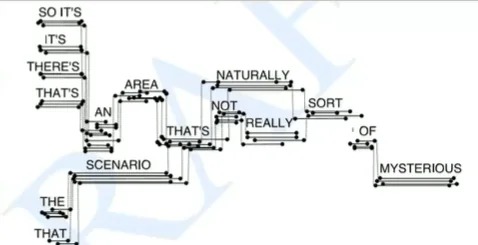
解码器的优化: Pruning 剪枝: 去除没有竞争力的路径。 Beam Search: 每帧只保留Best Path以及与Best Path距离小于beam-threshold的token。 Histogram Pruning: 每帧只处理前Top N个token。 可能去除了真正的Best Path。 树状字典:
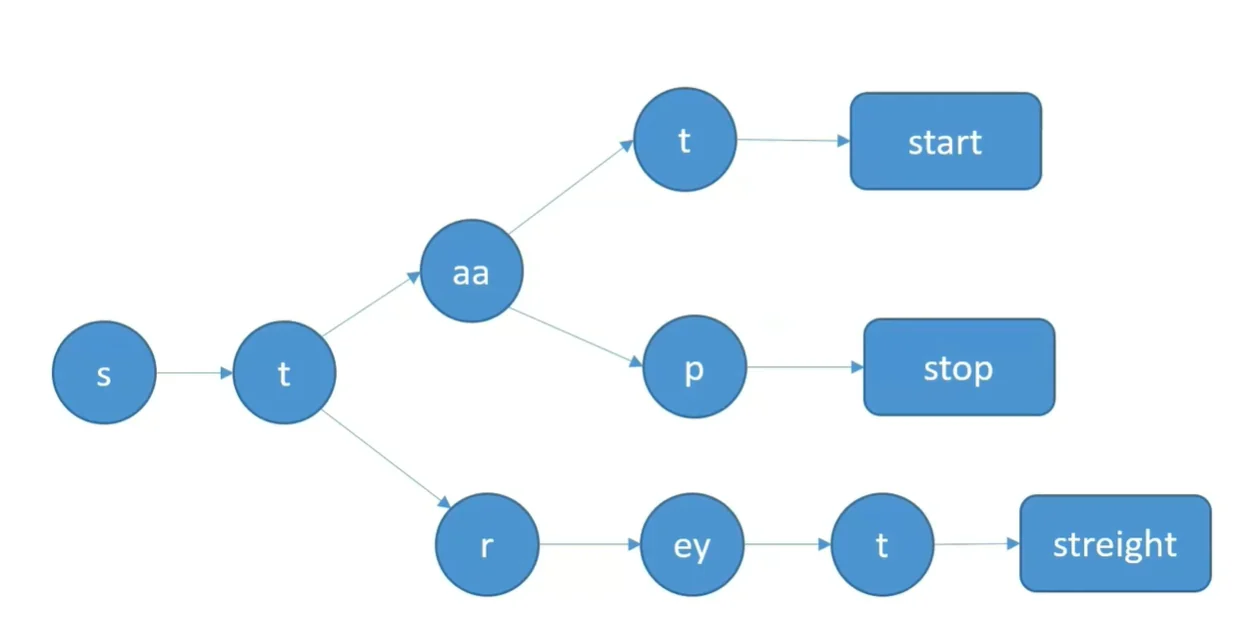
解码图:横坐标:观测序列(帧),纵坐标:状态序列
FSM: {state, arc(label(input, output)), weight}
发音词典则给出了每个单词对应的音素序列,如下图所示。目前,常用的开源中文词典有thchs30和CC-CEDICT,英文词典有CMU-dict。
4.1 相关链接
简书-形式运算-WFST中的代数半环:补一下数学基础
github-李想-WFST: 先介绍各类状态模型的概念,再说明WFST的相关算子,再说明相关算子在语音识别中的应用。 zhihu-欧阳盆栽-语音识别之WFST的“操作”: wfst的层级概念写得最直观
zhihu-周维-语音识别中的WFST和语言模型:补充例子 source_code-openfst:源码
4.2 基础概念
ε:没有接受字符就能跳转
FSA Finite-state Acceptor 有限状态接收器 WFSA Weighted Finite-state Acceptor 加权有限状态接收器 WFST Weighted Finite-state Transducer 加权有限状态转换器
WFST的三个层级:语言模型(文法)、发音词典、一个因子的HMM(一般为三状态) 对于语言模型的WFST:输入和输出字符串一模一样,因为语言模型是最终的输出。 对于发音词典的WFST:输入是因子(类似于一个音素?),输出是单词 对于一个因子的HMM的WFST:输入是因子的id,输出就是pdf-id。 注:发音词典会告诉我们一个单词对应的因子。 复合操作用来把两个不同层级的WFST“整合”成一个WFST。
半环(semi-ring):半环是一个非空集合 S,定义了两个二元运算:加法(\(\oplus\))和乘法(\(\otimes\)),满足以下条件:加法半群(加法的封闭性和结合律),乘法半群(满足乘法的封闭性,结合律),分配律,单位元(\(x\oplus \bar0=x\),其中\(\bar0\)称为0元; \(y\otimes \bar 1=y\),其中\(\bar1\)称为幺元 ),吸收率(a⋅0=0⋅a=0)。但不满足交换律,不一定存在加法逆元。五元组\((R,\oplus, \otimes, \bar0, \bar1)\)构成半环。 Log Semiring: \(S=(\mathbb{R} \cup \{-\infty, +\infty\}, \oplus_{log},+,+\infty, 0)\), 其中\(x \oplus_{log} y=-log(e^{-x}+e^{-y})\) Tropical Semiring: \(S=(\mathbb{R} \cup \{-\infty, +\infty\}, min,+,+\infty, 0)\), 其中\(x \oplus_{tropical} y=min(x,y)\)
在WFST中,每条边上不仅有一个输入标签和一个输出标签,还有一个对应的权重。半环的定义使得WFST相关操作的表达式可以统一。对于聚合,使用\(\otimes\)算子。例如,当权重是概率时,路径总权重一般为相乘;当权重是损失时,路径总权重一般是相加。
4.3 算子-组合
符号:\(A \circ B\) 从Mehryar Mohri1, F. P. a. M. R. (2002). "Weighted Finite-State Transducers in Speech Recognition."获取下图:
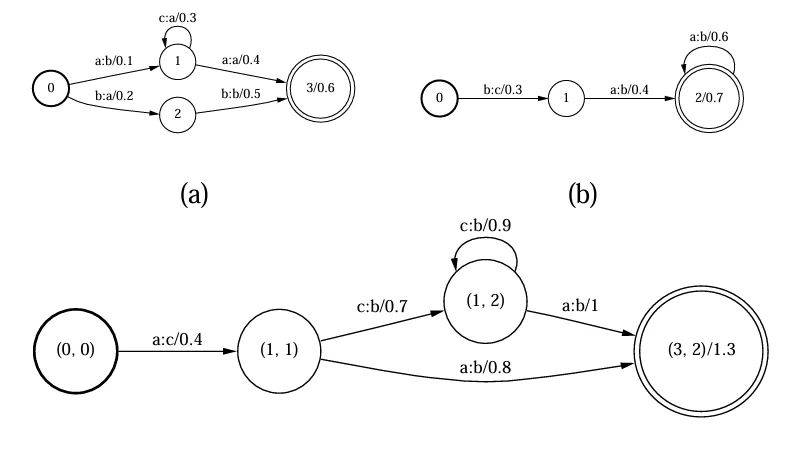
假设是热带半环。
| 弧 | Input: Output/ Weight |
|---|---|
| (0A,1A) | a:b/0.1 |
| (1A,1A) | c:a/0.3 |
| (0A,2A) | b:a/0.2 |
| (1A,3A) | a:a/0.4 |
| (2A,3A) | b:b/0.5 |
| 弧 | Input: Output/ Weight |
|---|---|
| (0B,1B) | b:c/0.3 |
| (1B,2B) | a:b/0.4 |
| (2B,2B) | b:b/0.6 |
| 弧 | Input: Output/ Weight |
|---|---|
| (0A,0B)→(1A,1B) | a:c/0.4 |
| (1A,1B)→(1A,2B) | c:b/0.7 |
| (1A,2B)→(1A,2B) | c:b/0.9 |
| (1A,2B)→(3A,2B) | a:b/1 |
| (1A,1B)→(3A,2B) | a:b/0.8 |
组合(Composition):如果A转换器的输出等于B转换器的输入,则 权重做代数加操作。参考bilibili-地球旅馆-WFST介绍-视频1小时整处
- 现在A图能走的链路,从(0A,0B)→(?,?)开始, 1.1 对于(0A,0A)→(1A,?),有A弧(0A,1A)的a→b,B中有弧(0B,1B)的b→c,因此生成弧{(0A,0B)→(1A,1B)}&a:c/0.4 和新状态 (1A,1B)。 1.2 对于(0A,0A)→(2A,?),有A弧(0A,2A)的b→a,而依然只有弧(0B,1B)的b→c。a≠b,所以无法生成新弧。
- 状态(1A,1B)→[(1A,?), (3A,?)],其中: 2.1 到(1A,?) 有c→a, 而(1B,2B)有a→b,因此可以有弧{(1A,1B)→(1A,2B)}&c:b/0.7 和新状态 (1A,2B)。 2.2 到(3A,?) 有a→a,而(1B,2B)有a→b,因此可以有弧{(1A,1B)→(3A,2B)}&c:b/0.8 和新状态 (3A,2B)。
- 状态(1A,2B)→→[(1A,?), (3A,?)],其中: 3.1 到(1A,?) 有c→a, 而(2B,2B)有a→b,因此可以有弧{(1A,2B)→(1A,2B)}&c:b/0.9,弧是自循环弧。 3.2 到(3A,?) 有a→a,而(2B,2B)有a→b,因此可以有弧{(1A,2B)→(3A,2B)}&a:b/1。
4.4 算子-确定化
如果一个图是确定化的,给定一个输入序列,在图中只能找到一条路径与其对应。
A weighted transducer is deterministic or sequential if and only if each of its states has at most one transition with any given input label.
并不是所有的非确定的WFST都可以转换成一个等价的确定的WFST.
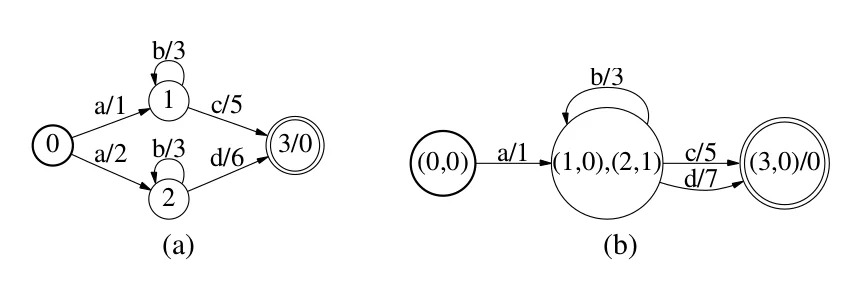
我们可以把状态1和2合并成一个状态<1,2>,但是状态0到状态<1,2>的weight是最短的1,然后我们在合并后的状态<1,2>里记录剩下的(remaining)的权重,记为<(1,0), (2,1)>。它的意思是进入状态1之后剩下的权重就是0了,而如果进入的是状态2,那么剩余的权重是1。
4.5 算子-最小化
4.6 HCLG
在基于加权有限状态转换器(WFST)的语音识别模型中,HCLG解码网络由四个核心组件逐层组合而成,各组件的输入输出关系及功能如下表所示:
| 组件 | 全称 | 输入 | 输出 | 核心功能 | 权重处理 |
|---|---|---|---|---|---|
| H | HMM声学模型WFST | HMM transitions-ids(声学特征编码ID) | 上下文相关音素(triphone) | 将声学特征序列映射为上下文相关的音素序列,代表声学模型概率 | 包含声学成本(如HMM似然值),权重为负对数概率 |
| C | 上下文相关WFST | 上下文相关音素(triphone) | 上下文无关音素(monophone) | 处理音素的上下文依赖关系,将三音素转换为单音素 | 无额外权重,仅传递输入输出符号 |
| L | 发音词典WFST | 上下文无关音素(monophone) | 词汇(单词) | 将音素序列映射为单词序列,基于发音词典构建 | 包含发音词典权重(如音素到单词的映射概率) |
| G | 语言模型WFST | 词汇(单词) | 词汇(单词) | 判断词序列的语法合理性及概率(如N-gram模型),作为接受机(acceptor) | 包含语言模型成本(如词序列概率),权重为负对数概率 |
组合逻辑与优化
- 逐层合并:通过
HCLG = min(det(H o min(det(C o min(det(L o G)))))的顺序逐层合并,其中: o表示复合操作(整合不同层级WFST),det表示确定化(消除非确定性路径),min表示最小化(减少冗余状态和边)。- 权重融合:最终路径的权重为声学成本(H) + 语言模型成本(G) + 上下文/发音词典成本(C+L),搜索时寻找总权重最小的路径。
- 关键操作:包括空弧消除(ε-removal)、权重前推(weight-pushing)和状态最小化,以提升解码效率。
4.7 令牌传播机制
五、识别vs唤醒
语音识别:主要依赖于深度学习模型,如循环神经网络(RNN)、长短时记忆网络(LSTM)和全连接时序分类模型(CTC)等,以识别语音中的词汇内容。 语音唤醒:通常使用关键词检测或关键词识别技术,这些技术可以在连续语音流中快速检测特定的唤醒词或关键词。常用的实现方式包括深度神经网络(DNN)、隐马尔科夫模型(HMM)等。
六、模型参数
nDimSplitStep:解码多 beam 之间的跳转步数acmodel_prior_factor:声学模型先验因子acmodel_scale:声学模型系数lmscale:二遍语言模型分数系数wordpenalty:二遍词语惩罚系数merge_cut_lattice:二遍时是否进行路径减支decoderNetType:解码类型
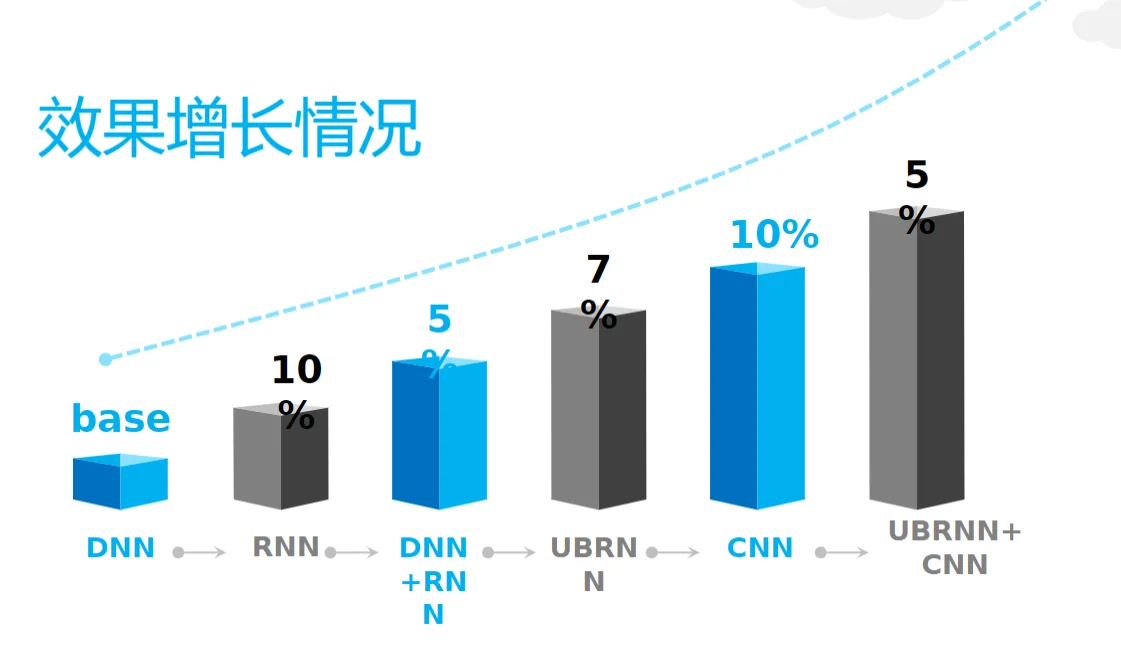
七、模型效果
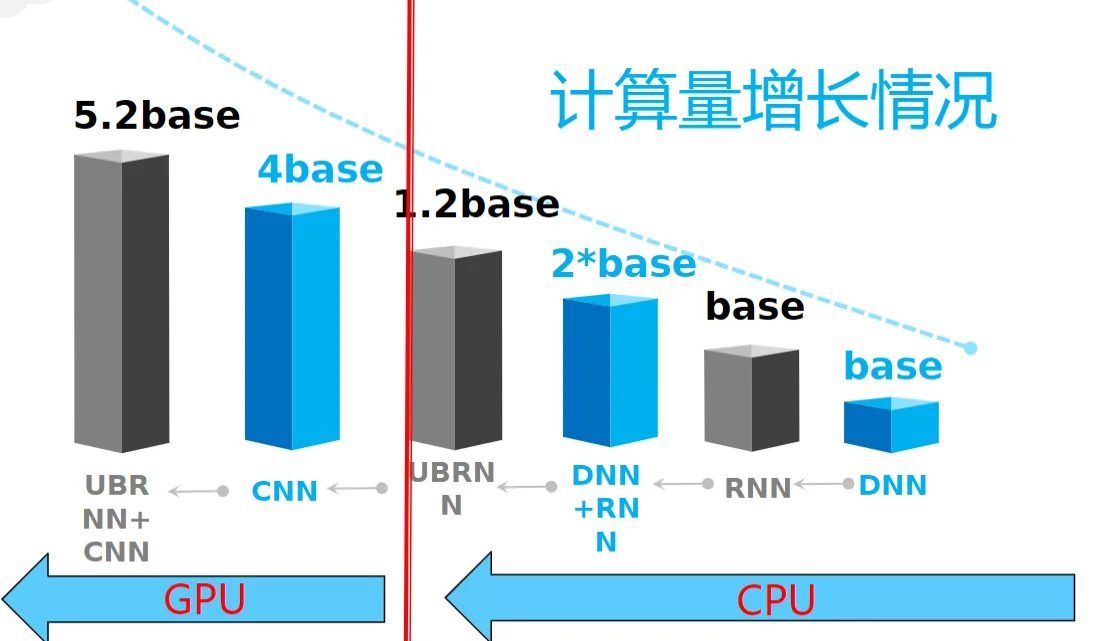
八、评价
句错误率:Sentence Error Rate 解释:句子识别错误的个数,除以总的句子个数即为SER
WER,Word error rate,词错率,但一般称为字错率,是语音识别领域的关键性评估指标,WER越低表示效果越好! CER,Character Error Rate,字符错误率,中文一般用CER来表示字错率。
英文,因为最小单元是Word,语音识别应该用"字错误率"(WER), 中文,因为最小单元是字符,语音识别应该用“字符错误率”(CER)。
8.1 Levenshtein距离
csdn-Jeremy-If-Levenshtein距离算法
Levenshtein距离又称作编辑距离(Edit Distance),是指两个字符之间,有一个转变成另一个所需的最少编辑操作次数。
给定两个字符串 \(X = x_1x_2\cdots x_m\) 和 \(Y = y_1y_2\cdots y_n\),Levenshtein 距离 \(\text{lev}_{X,Y}(i,j)\) 表示将 \(X[1..i]\) 转换为 \(Y[1..j]\) 的最小操作次数(插入、删除、替换)。定义如下:
其中,\(\mathbb{1}_{x_i \neq y_j}\) 是指示函数(若 \(x_i \neq y_j\) 则为 1,否则为 0)。
九、新架构
9.1 发展历史
GMM-HMM → DNN-HMM(混合) → LSTM+CTC(初代端到端CTC) → wav2vec2+CTC(自监督增强CTC) → RNNT → LLM-ASR / Omni多模态大模型
https://mp.weixin.qq.com/s/k1xkCw75Oenn_wbeOTaa8g
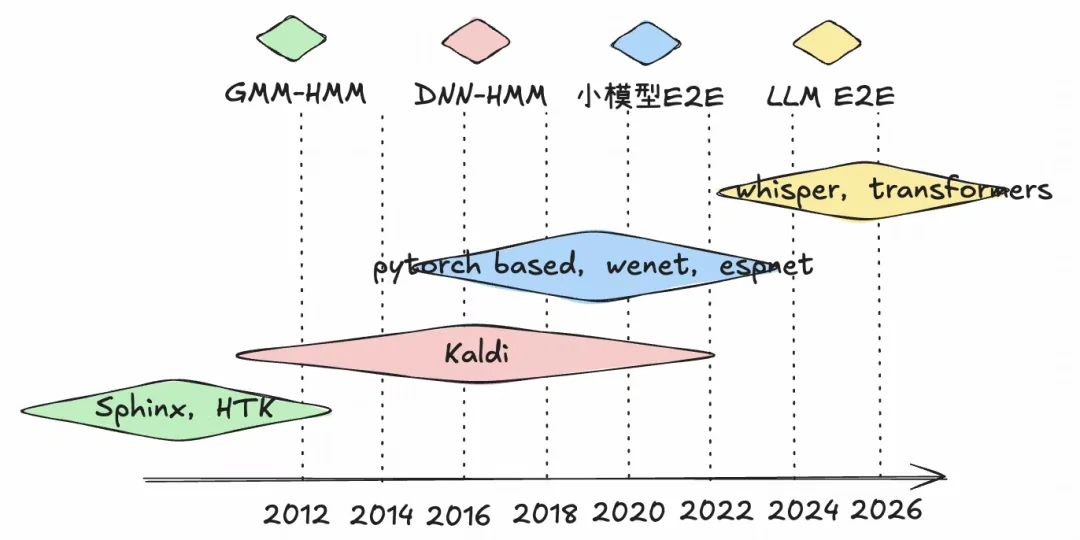
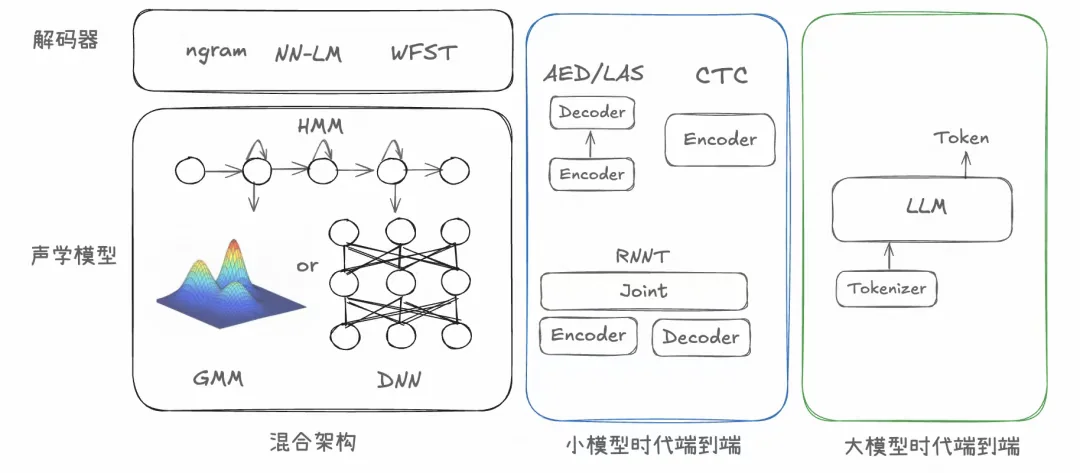
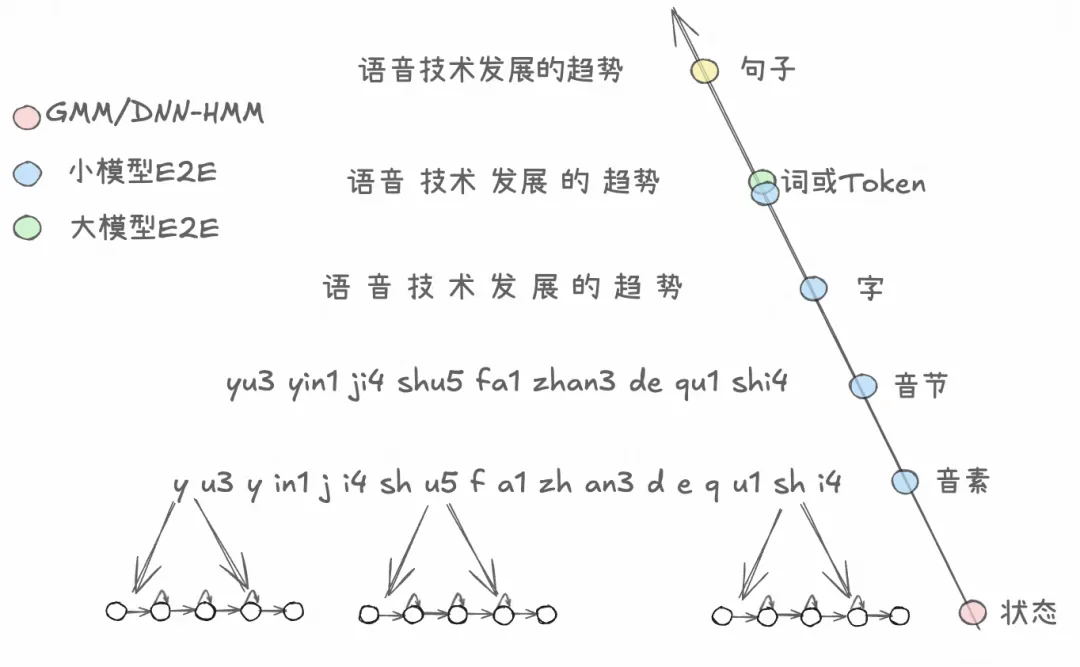
大模型时代没有垃圾数据,只有未被充分利用的数据。未来需要更加充分地挖掘数据价值。
9.2 比较
级联系统优势:可控性强、各模块单独优化、融合外部知识、使用范围广。 级联劣势:多模态统一建模友好、工程实现相对复杂、延时问题、情感副语言丢失、语音合成的情感和自然度。
交互过程中的When-How-What-Why,统一由模型进行决策:
- When:机器什么时候开始说话、什么时候停止说话、什么时候可以附和、甚至什么时候可以主动抢话和打断用户(理论上)
- How:机器如何回复,用什么语音语调、音色、情感、语速、方式进行回复
- What:机器应该回复什么内容
- Why:为什么这样回复,可以理解为思考的过程
个人认为,如果完全端到端了的话,其实和认知上的真正意义的人工智能基本一致了。
端到端系统的挑战:智商保持;外部知识融合;训练过程复杂,迭代和迁移困难;实时推理挑战;
能力不是来自于模型,而是数据。
9.3 RNNT
RNNT:完整端到端 ASR 模型,由三部分联合优化:
- Encoder(声学编码,对应声学模型)
- Predictor(内部 LM,建模已经输出 token 的上下文)
- Joint(融合二者,计算输出分布)
9.4 CTC
TODO
Sequence Modeling with CTC [1] Graves A, Fernández S, Gomez F, et al. Connectionist temporal classification: labelling unsegmented sequence data with recurrent neural networks[C]//Proceedings of the 23rd International Conference on Machine Learning. ACM, 2006: 369-376. [2] Graves A, Jaitly N. Towards end-to-end speech recognition with recurrent neural networks[C]//Proceedings of the 31st International Conference on Machine Learning. PMLR, 2014: 1764-1772.
9.4.1 LSTM+CTC
早期端到端 ASR
- 前端手工特征提取:原始波形 → 预加重、分帧 → FBank / MFCC(人工设计特征)
- 声学编码器:多层双向 LSTM(BiLSTM)
- 输入:手工声学特征序列
- BiLSTM:同时利用过去 + 未来帧上下文,建模时序依赖
- 投影层:将 LSTM 输出的隐状态映射到字符 / 音素词汇维度,输出每帧概率
- 训练:CTC 损失,边缘化所有合法对齐路径,不需要帧级对齐标签
-
解码:维特比;或 WFST + 外部 N-gram LM 重打分
-
依赖手工特征(MFCC/FBank),特征提取是固定的,模型不能从原始波形学习底层声学模式;
- 必须大量带标注语音数据才能训练;小数据场景效果差;
- LSTM 并行能力弱,长序列建模能力弱于 Transformer。
9.4.2 wav2vec2+CTC
wav2vec2+CTC:自监督预训练 + 监督微调。声学底层知识在无标注阶段就学到,标注只用来学习语音到文本的映射。
9.5 Omni模型
交叉训练任务: 任务1(文本→音频):给模型输入文本片段(“你好”),要求它预测对应的音频片段(生成语音)。 任务2(音频→文本):给模型输入音频片段(语音波形),要求它预测对应的文本片段(语音识别)。 通过这两个任务,模型同时学习文本和音频的表示(即如何将文本转化为音频,以及如何将音频转化为文本)。
多流预测的核心逻辑:在交叉预测的基础上,模型同时维护多个独立的“预测流”(如文本流和音频流),每个流独立处理对应类型的数据,但通过共享底层参数实现协同。
输入文本流和音频流外,还可以输入语义流。 Semantic tokens 是在编程和自然语言处理(NLP)中使用的基本元素,通常用于表示文本的最小语义单位。在语言服务器开发中,semantic tokens 定义了一组令牌类型和修饰符,允许客户端扩展这些标记类型,以支持不同的功能。在机器学习领域,token 通常被视为处理文本的基本单元,能够通过数字表示单词或符号。
十、打字机
"打字机"就是 PGS(Progressive result,流式/实时转写结果)
认知心理学视角 人类大脑处理信息存在"渐进式理解"机制,每秒接收 3-5 个字符的速率与自然阅读节奏匹配。实验数据显示,采用打字机效果可使用户平均等待耐受时间从 8.2 秒延长至 23.5 秒,焦虑指数下降 57%。
交互设计优化 通过控制字符输出速度(通常 150-300ms/字符),可模拟人类对话的节奏感。配合光标闪烁动画(CSS
@keyframes实现),能显著提升对话的真实感,用户沉浸度提升 40% 以上。
10.1 传统打字机
传统打字机:流式输出并逐字符展示。国内老教材一般叫听写机,英文文献叫 speech typewriter
- 传统打字机:模块化 pipeline(特征→HMM 声学模型→词典→Ngram→WFST/Viterbi 解码),显式分音素、词、语言模型。
- CTC/Transformer/Conformer:端到端,直接音频→字符 / 子词序列,不再显式维护音素 HMM 链。
技术点:
- 匀速逐字外抛:基于打字机引擎能力和统计结果,假设打字机每400ms出一次结果,一次结果出3个字
ABC,设置最大字间隔150ms,最小0ms,此时第一打印第一个字后,后面的字以133ms为sleep间隔发出。在t0+200ms时,已经抛出AB,假设又来了DE,是等到下本轮ABC都吐字完成了,在基于基础策略处理DE,还是收到新字后,立即基于CDE重新计算,都是可行的。具体看实际体验效果。 - 字数回退过滤:避免出现字数多到字数少的跳变
- 文本后处理:经过语义模块对打字机进行文本规整,过滤敏感词
- 端云打字机:一般有两种处理形式,有云端现有云端,谁字多用谁。
10.2 大模型下的打字机
大模型下经常出现markdown的表格、加粗等处理。
javascript - 浅谈 AI 搜索前端打字机效果的实现方案演进 - vivo 互联网技术 - SegmentFault 思否
v-md-editor和SSE实现ChatGPT的打字机式输出-腾讯云开发者社区-腾讯云
十一、开源仓库
对于语音识别(Speech Recognition)的开源代码,以下是一些值得推荐的项目:
Mozilla DeepSpeech:Mozilla的DeepSpeech项目是一个开源的端到端语音识别引擎,使用深度学习模型直接从原始音频中识别文本。这个项目提供了预训练的模型,并且提供了在多种语言上训练模型的能力。
GitHub链接: https://github.com/mozilla/DeepSpeech
CMU Sphinx:卡内基梅隆大学(CMU)的Sphinx是一个较早的开源语音识别引擎,提供了基于隐马尔可夫模型(HMM)的识别技术。虽然Sphinx可能不是最新的技术,但它仍然是一个可靠且易于使用的工具,适合初学者入门。
GitHub链接: https://github.com/cmusphinx/pocketsphinx
TensorFlow Speech Recognition:TensorFlow是一个流行的深度学习框架,它包含了一些用于语音识别的库和示例代码。TensorFlow Speech Recognition通常使用RNN(循环神经网络)或Transformer模型,并提供预训练的模型和教程。
GitHub链接: https://github.com/tensorflow/models/tree/master/official/projects/speech
PyTorch Audio:PyTorch是另一个流行的深度学习框架,其音频库提供了用于语音处理和语音识别的工具。用户可以借助PyTorch Audio构建自定义的语音识别模型,并利用其丰富的深度学习库进行优化。
GitHub链接: https://github.com/pytorch/audio
https://zhuanlan.zhihu.com/p/186741491
https://zhuanlan.zhihu.com/p/62836549
11.1 格式
arpa language models, n-gram统计下的文本存储格式。
11.2 Kaldi
Kaldi:Kaldi是一个由约翰斯·霍普金斯大学(Johns Hopkins University)开发的开源语音识别工具箱。它被广泛用于工业界和学术界,因为它提供了高性能的语音识别技术,并且其设计非常模块化,方便用户定制和优化。
GitHub链接: https://github.com/kaldi-asr/kaldi kaldi-doc
github-李想-Kaldi文档解读 csdn-wbglearn